 DTEmpower
墨水配方成本优化(回归预测与数据分析)
背景
在墨水、涂料、胶黏剂等新材料研发中,配方通常由多种原料按不同比例组合而成。原料价格波动频繁,且高性能组分往往成本较高;仅依赖研发人员经验进行配方调整,容易出现反复试验次数多、降本空间难以量化、性能与成本难以兼顾等问题。
传统的回归预测侧重于根据配方组分预测某一项性能数值,而本案例将问题进一步转化为成本优化:以历史配方及性能数据为基础,在拉伸性能、粘度等关键性能满足要求的前提下,主动搜索原料配比的优化方案,使配方总成本尽可能低。
本案例使用 DTEmpower 对墨水配方数据和原料单价数据进行分析。配方数据包含 94 条历史样本、126 个原料用量特征,以及「拉伸性能」「粘度」两项性能指标;原料成本表包含 126 种原料的单位成本。平台先基于墨水配方数据训练性能预测模型,而后基于历史配方的原料用量边界和总量约束生成候选配方,再通过性能预测模型筛选拉伸性能大于 2、粘度介于 15 至 17 的合格方案,并结合原料单价计算单位成本,为研发人员提供兼顾性能与成本的配方优化参考。
优化目标: 保证关键性能合格的前提下,尽可能降低墨水配方的单位成本。
性能约束: 拉伸性能大于 2,粘度在 15 至 17 之间。
案例数据集
本案例包含用于模型训练、成本计算和物料属性统计的 3 个 CSV 文件:
墨水配方_机器学习数据.csv:包含原料用量、拉伸性能和粘度的历史配方数据;墨水材料每kg成本表.csv:记录各原料的单位成本;物料属性.csv:记录物料代码与物料属性的对应关系。- 下载墨水配方成本优化数据集
操作流程
案例功能点概述:
通过本案例操作,用户将学习如何在 DTEmpower 中完成材料配方成本优化的完整流程,包括:
- 导入包含原料用量、拉伸性能和粘度的墨水配方历史数据,了解配方特征与性能指标的对应关系;
- 使用专家模式的回归预测功能,以「拉伸性能」和「粘度」为目标训练模型,比较不同算法效果并部署适用模型;
- 使用智能数据处理功能,在原料用量边界和配方总量为 100% 的约束下进行采样,生成可行的候选配方;
- 导入原料单位成本表,调用已部署的性能预测模型对候选配方进行预测,筛选拉伸性能大于 2、粘度介于 15 至 17 的合格方案;
- 根据原料用量和单位成本计算候选配方的单位成本,按成本从低到高筛选出低成本配方;
- 通过散点图、配方组成表和物料属性占比图,分析成本与性能的关系、最低成本配方的原料构成及样本中不同物料属性的占比。
建立项目
在 DTEmpower 中,点击【新建项目】,输入项目名称并点击【确认】创建项目。
 建立项目
训练上传数据
进入项目后,点击【导入数据】,选择【上传】。
 导入训练数据
选择需要上传的训练数据进行导入。
 选择训练数据
数据中共有 126 个原料用量特征,以及「拉伸性能」「粘度」两项性能指标。每个原料用量特征表示该原料在配方中所占百分比。「拉伸性能」「粘度」则表示配方的物理性能指标,用于评估配方的质量和适用性。
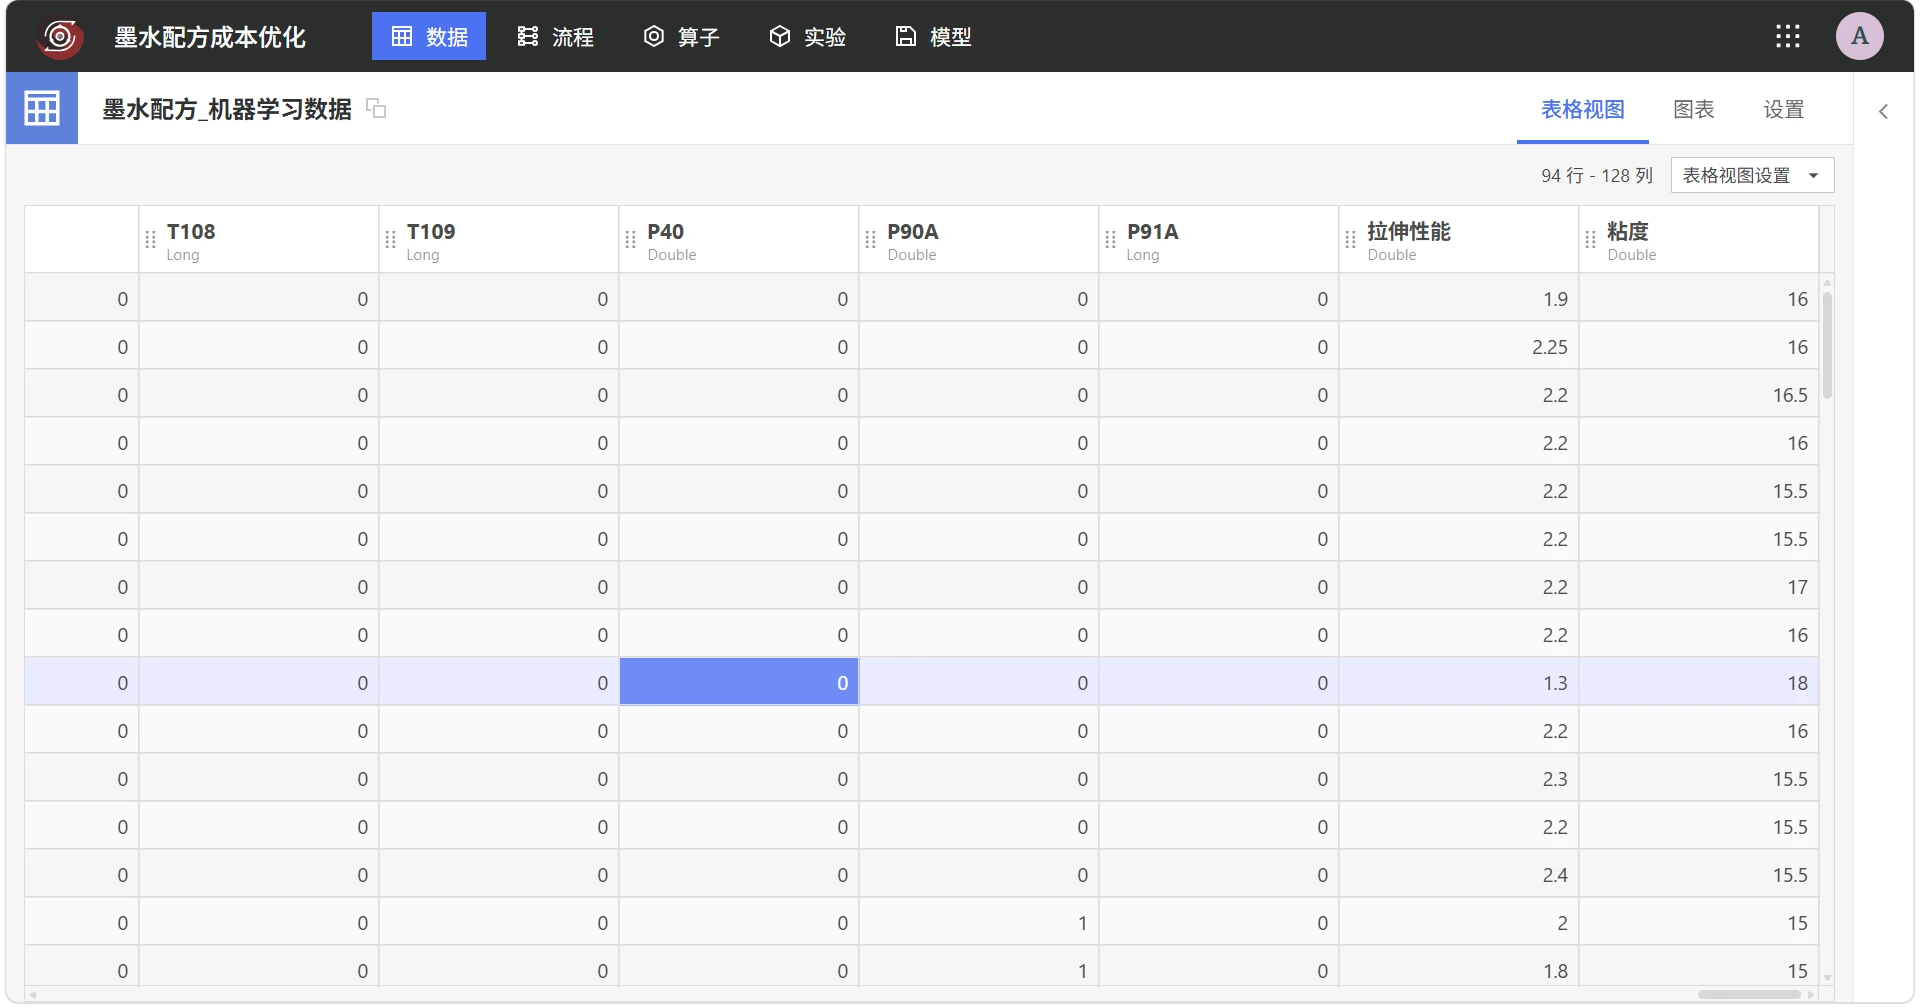 训练数据预览
模型训练
在「流程」中,点击导入的训练数据,选择右侧的【回归预测】模块。
 选择回归预测
「目标列名」选择「拉伸性能」和「粘度」。「自动机器学习」模式下,平台会自动选择最优的模型进行训练,较适合新手。「专家模式」下,用户可以手动选择模型参数,进行更复杂的模型训练。此处选择「专家模式」,选择不同算法进行模型训练。
 配置目标列和训练模式
因训练样本数较少,在「训练/测试集」中,将「训练集占比」设置为 0.85,略微增加模型训练数据量。
 配置训练集占比
在「算法选择」中,勾选所有算法,参数均采用默认值,点击右上角的【训练】按钮开始训练。
 选择算法
可以选择「启用 GPU 进行回归预测模型训练」使用 GPU 进行训练加速,输入「任务名称」,点击【训练】按钮开始训练。
 启动训练
模型部署
训练完成后,可切换「拉伸性能」和「粘度」,查看模型在不同性能指标下的预测结果。
 拉伸性能预测结果
 粘度预测结果
此处选择 Random Forest 模型,点击【查看详情】。
 查看模型详情
在「特征重要性排序」中,可查看每个特征对模型预测的影响程度。
 特征重要性排序
点击右上角的【部署】按钮,将模型部署到生产环境中。
 部署模型
模型部署完成后,该模型将出现在「流程」画布中。
 已部署模型
数据采样
选择训练数据集,点击右侧【智能数据处理】模块。
 选择智能数据处理
新增采样列表,点击【确认】。
 新增采样列表
使用【智能数据处理】模块进行采样,输入以下提示词:
对该配方表进行约束采样:仅排除“拉伸性能”和“粘度”,其余所有列均为配方材料。

每种材料必须处于原始数据对应列的最小值和最大值之间,恒定列保持原值,所有材料之和严格等于 100(误差 ≤ 1e-6)。先检查可行性:各材料最小值之和 ≤ 100 ≤ 各材料最大值之和;若不满足,停止并说明原因。

采用多起点有界单纯形 Hit-and-Run MCMC 采样:以原始配方为多个起点,随机移动方向必须满足各材料变化量之和为 0,并根据各列 min-max 计算可行步长,使每一步天然满足范围和总和约束。生成 2,000 条有效样本,并补充可行的材料边界样本以提高覆盖度。

导出采样 CSV,并逐行验证所有材料均在 min-max 范围内、材料总和 = 100、恒定列未变化;删除不合格样本并补采,直至最终输出恰好 2,000 条合格样本。
智能体执行完成后即可得到采样的数据集,并检测数据是否符合要求。
 采样结果
成本计算
点击【导入数据】,选择【上传】。
 导入成本表
选择墨水成本表进行导入。
 选择成本表
该成本表包含每个原料的单位成本,后续将用于计算配方成本。
 成本表预览
在模型中找到先前部署的 Random Forest 模型。
 定位已部署模型
点击【查看详情】。
 查看部署模型详情
在「接入指南」中,找到「AI 提示词」。该提示词将用于后续的成本计算。
 复制 AI 提示词
回到「流程」画布,选择「采样」数据集,点击右侧【智能数据处理】模块。
 处理采样数据
输入数据集为「采样」和「墨水材料每kg成本表」,输出为「成本优化」表。
 配置成本优化任务
请先在「接入指南」中复制已部署模型生成的完整提示词,再在智能体对话框中追加以下要求:
[复制的提示词]
调用上述模型,使用采样的数据进行预测,筛选拉伸性能大于 2、粘度在 15 至 17 之间的结果,并根据墨水材料的成本表计算成本。采样表中数据为百分比,因此对计算成本除以 100,得到单位成本。输出包含物料、性能和成本的表,将成本由低到高排序,输出前 40 行。
 执行成本优化
智能体运行完成后,可见输出的数据集中已经计算出「拉伸性能」、「粘度」和「单位成本」。
 成本优化结果
数据分析与统计
成本与性能关系分析
在「流程」画布中,选择输出的「成本优化」表,点击右侧【查看】。
 查看成本优化表
点击「图表」,选择「2D 散点图」,按图示拖拽变量到图表中。由于采样较为密集,40 个样本中存在近乎相同的样本,散点图上的点并没有 40 个。该图可查看「单位成本」与「拉伸性能」「粘度」等指标的关系,找到成本更低的配方。
 成本与性能散点图
最低成本配方组成分析
采用【智能数据处理】提取成本最低的样本。
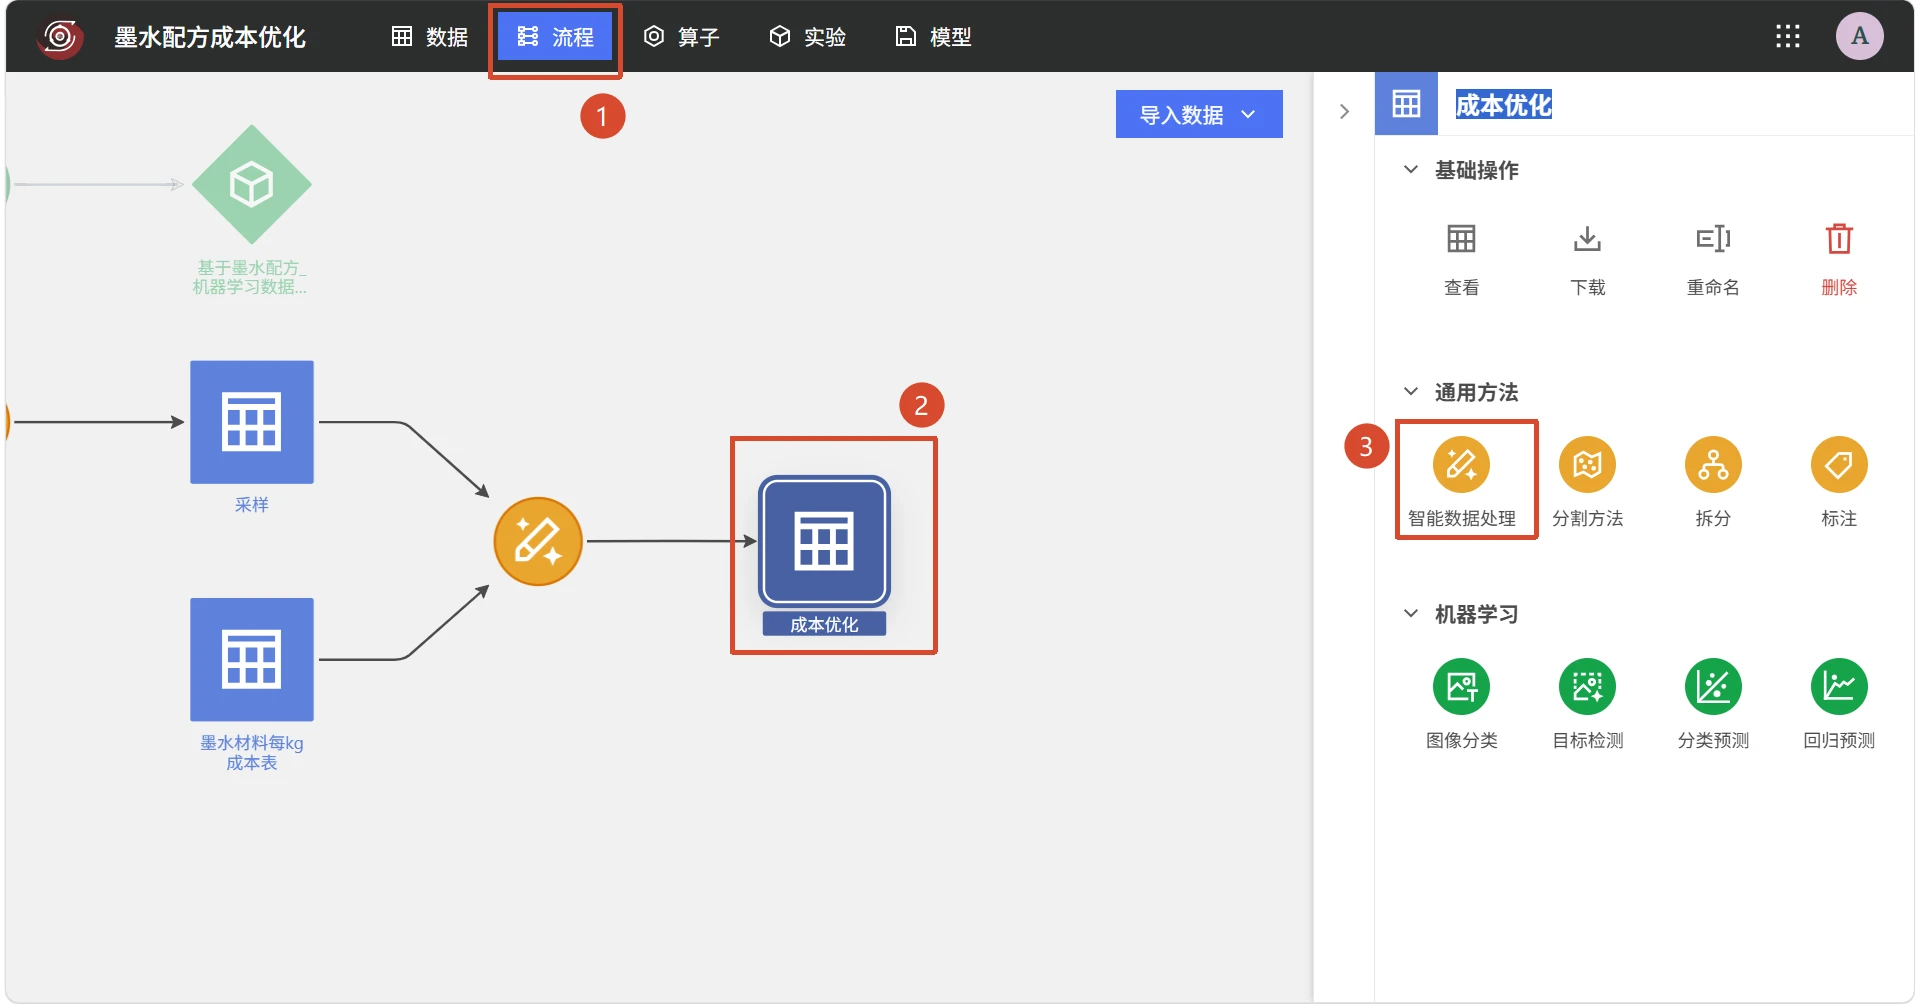 选择最低成本样本
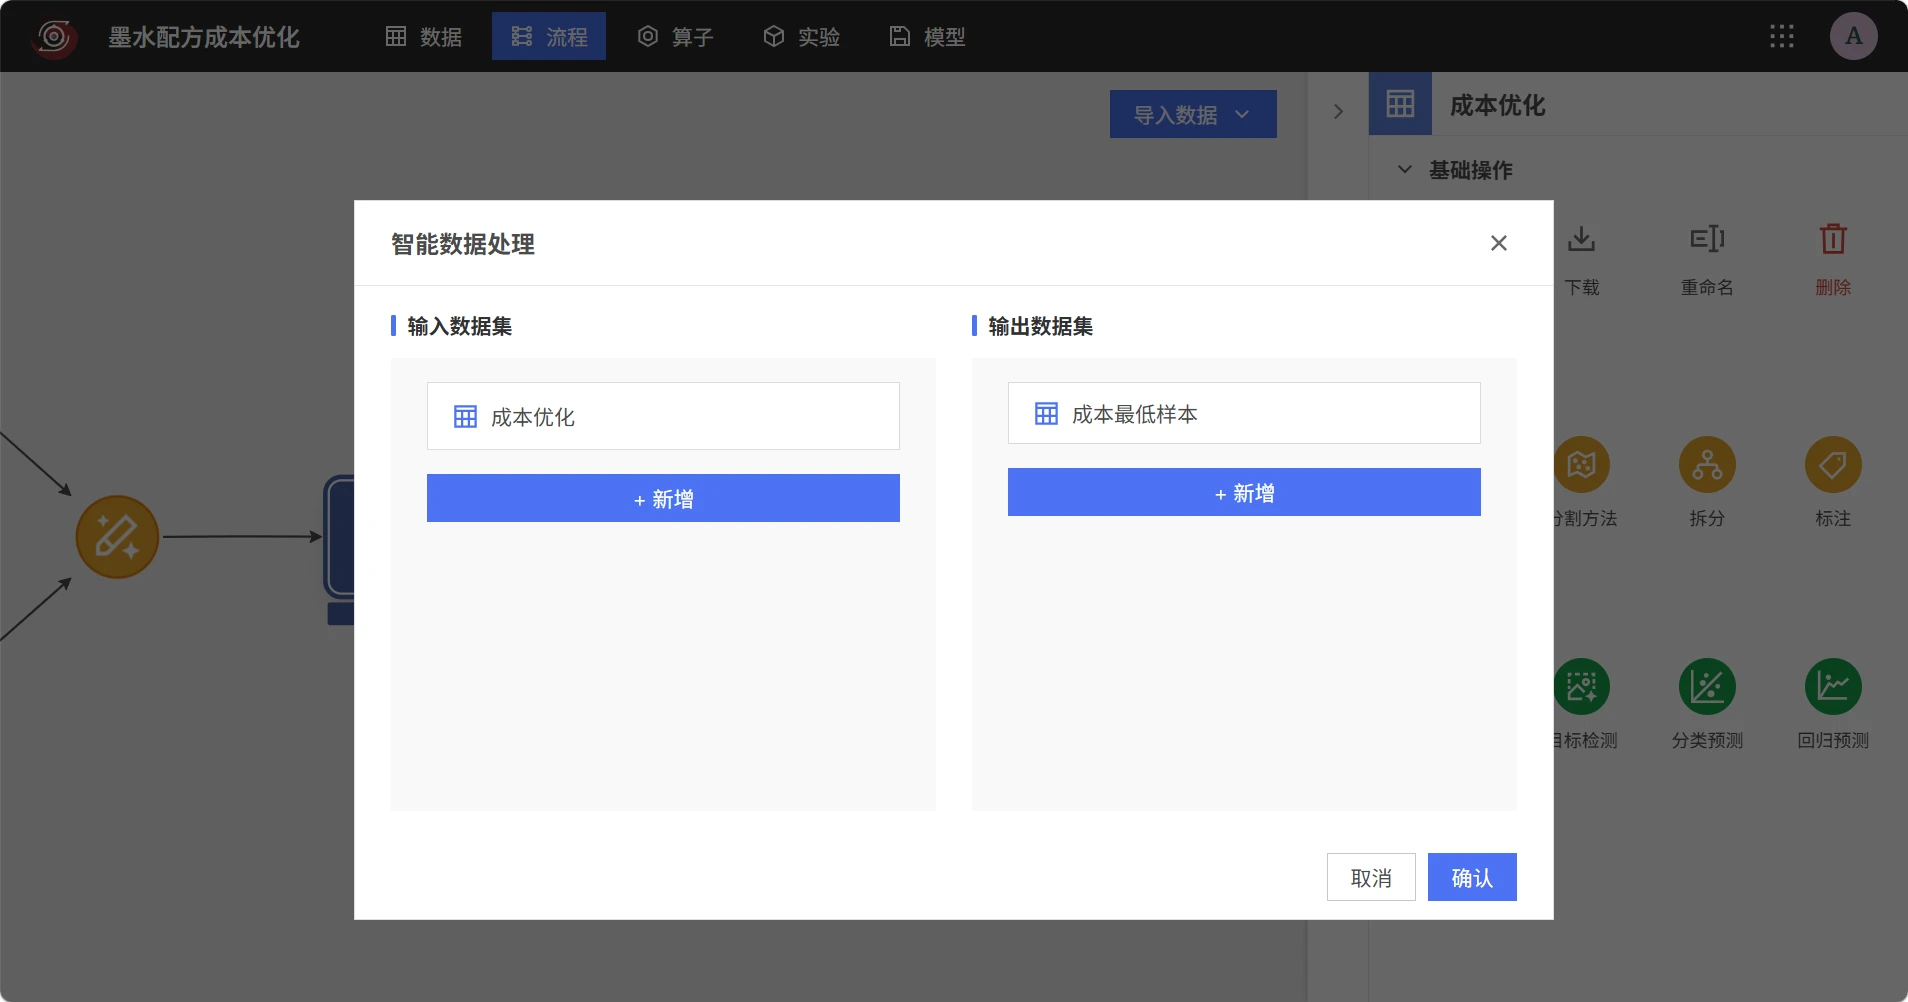 配置最低成本配方任务
输入如下提示词:
使用第一列最低样本,建立一张“最低成本配方组成表”,采用两列纵表,一列为材料名一列为材料占比。
等待智能体运行完成,可见最低成本配方中只有 10 种材料,其他材料占比均为 0。
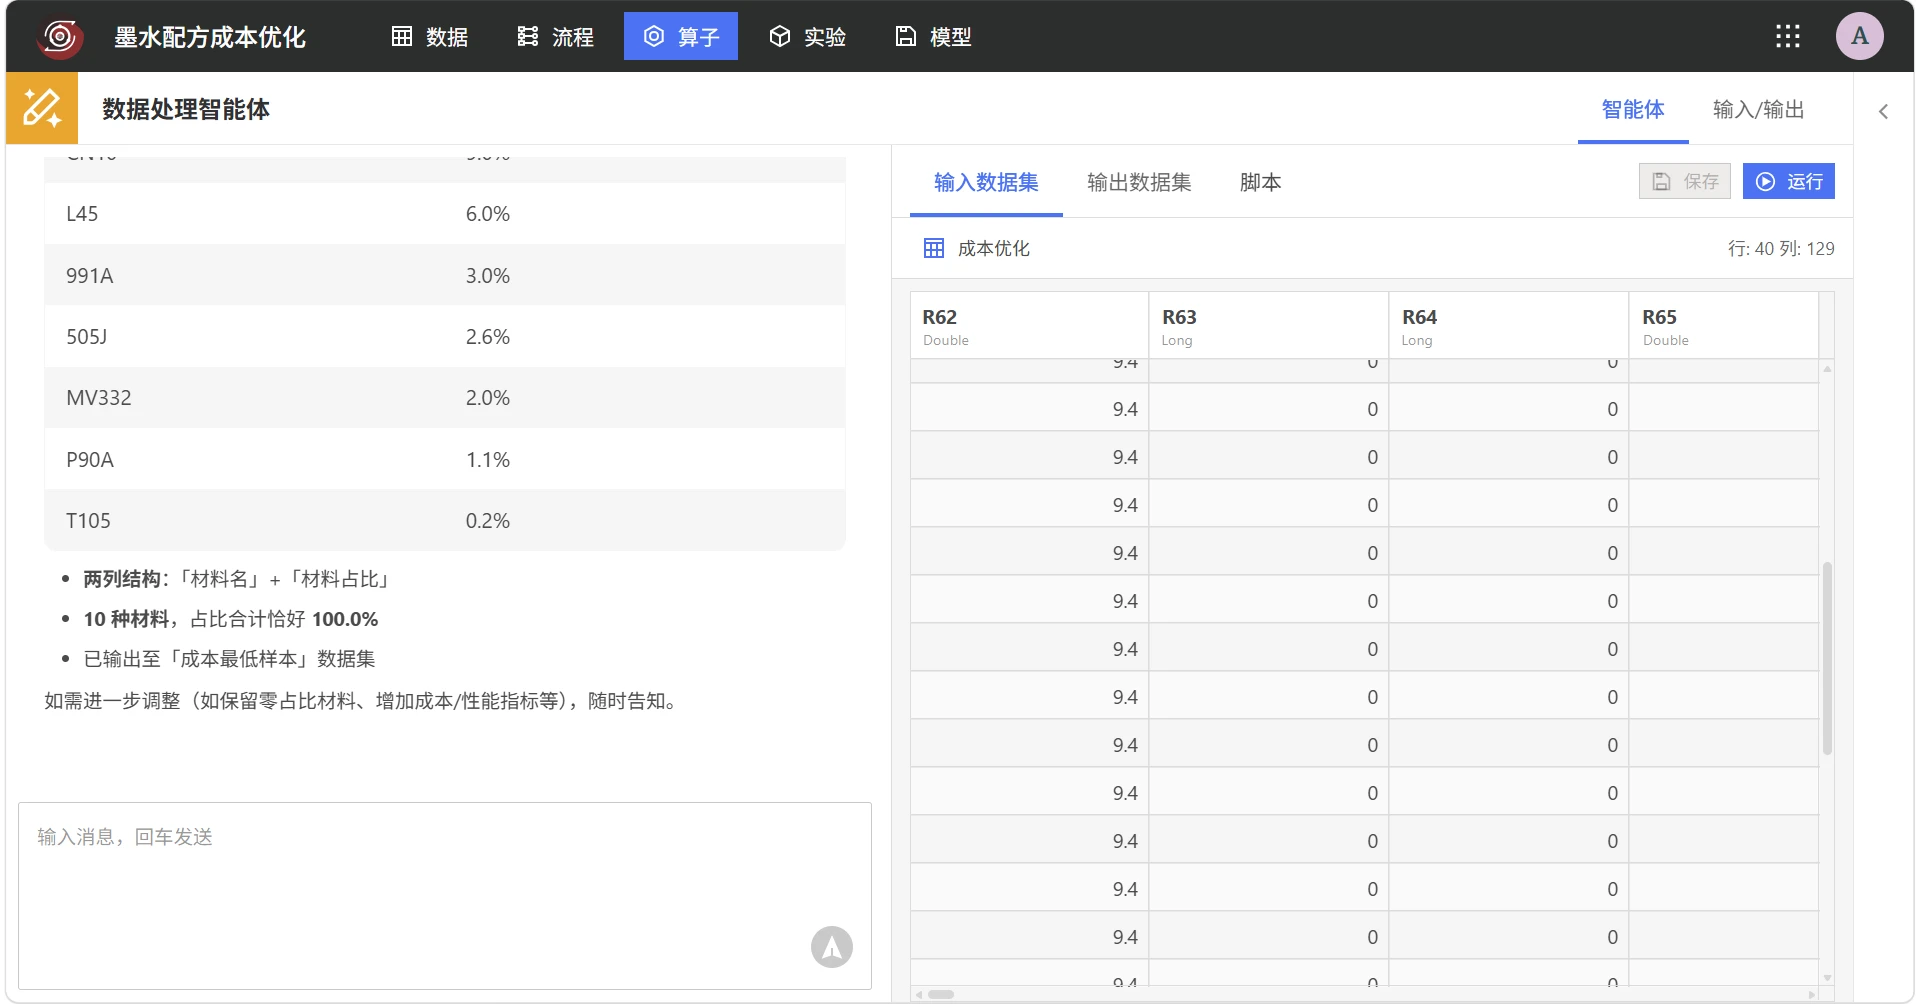 最低成本配方处理结果
查看生成的最低成本配方组成表。
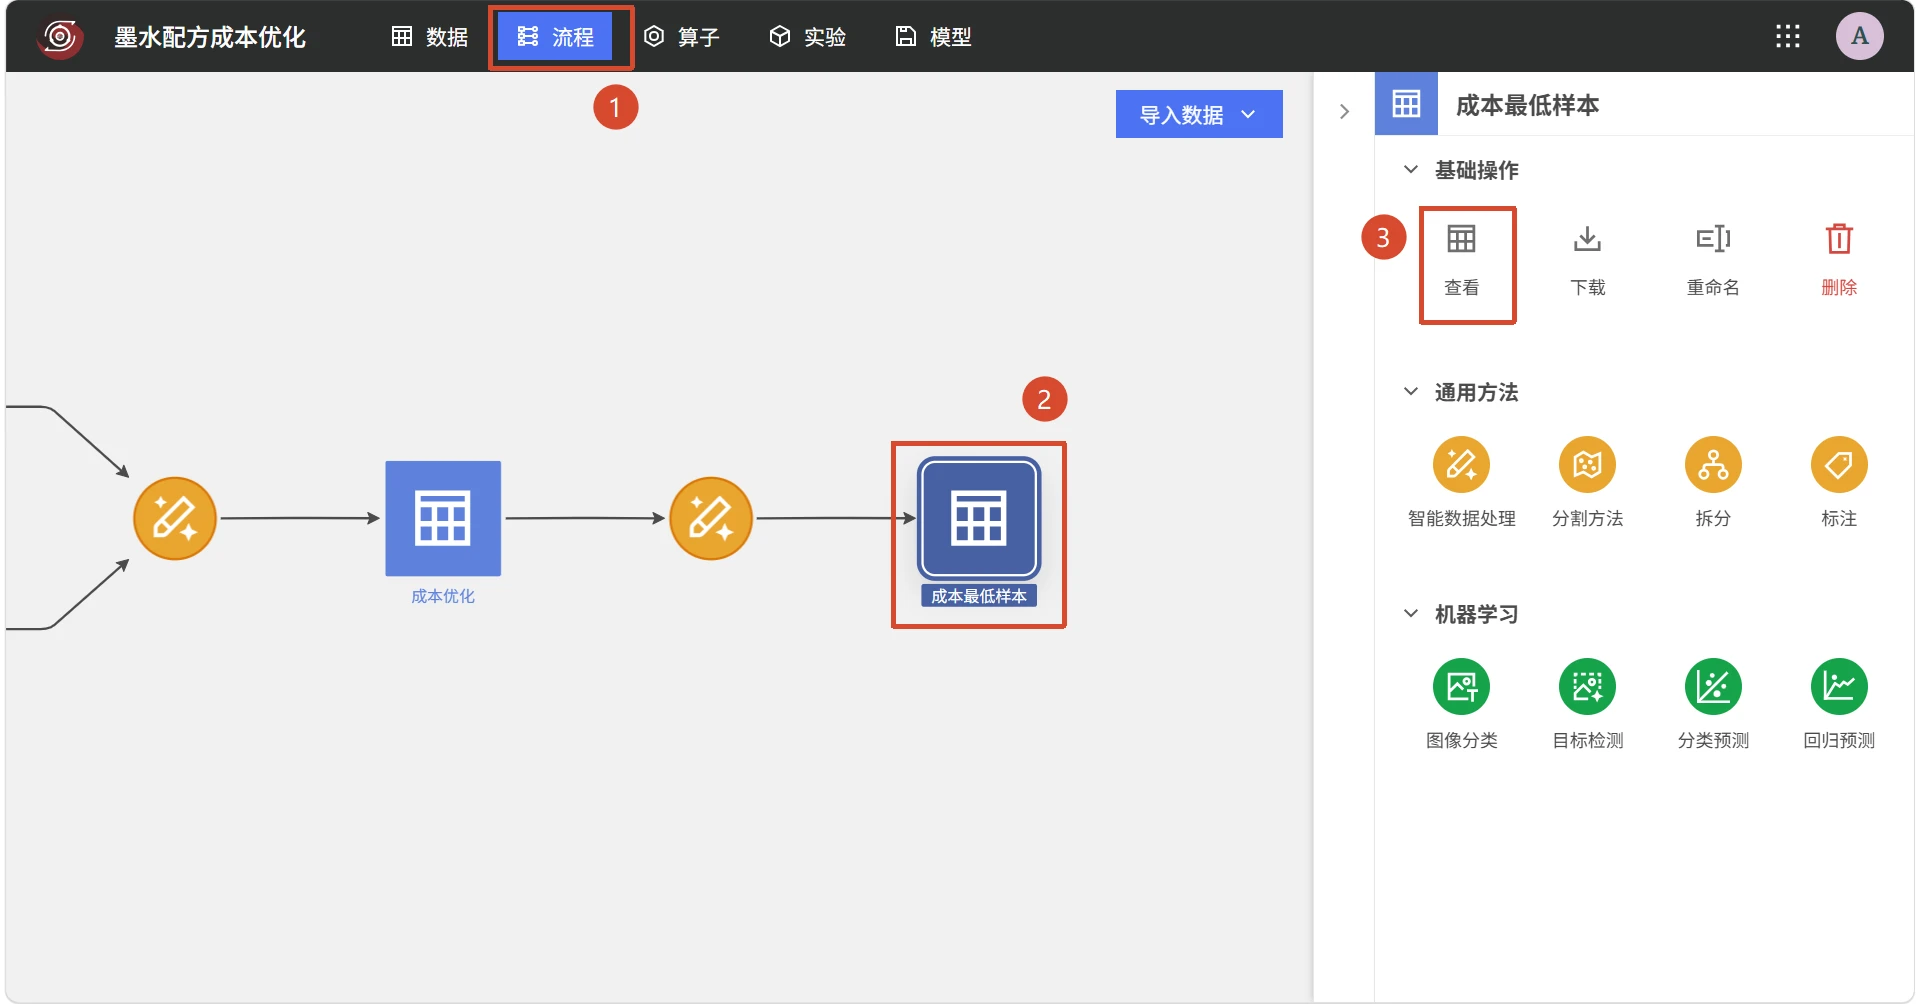 最低成本配方组成表
通过饼图可以清晰地查看各类材料的占比。其中 711D 的占比最高,为 39.1%。
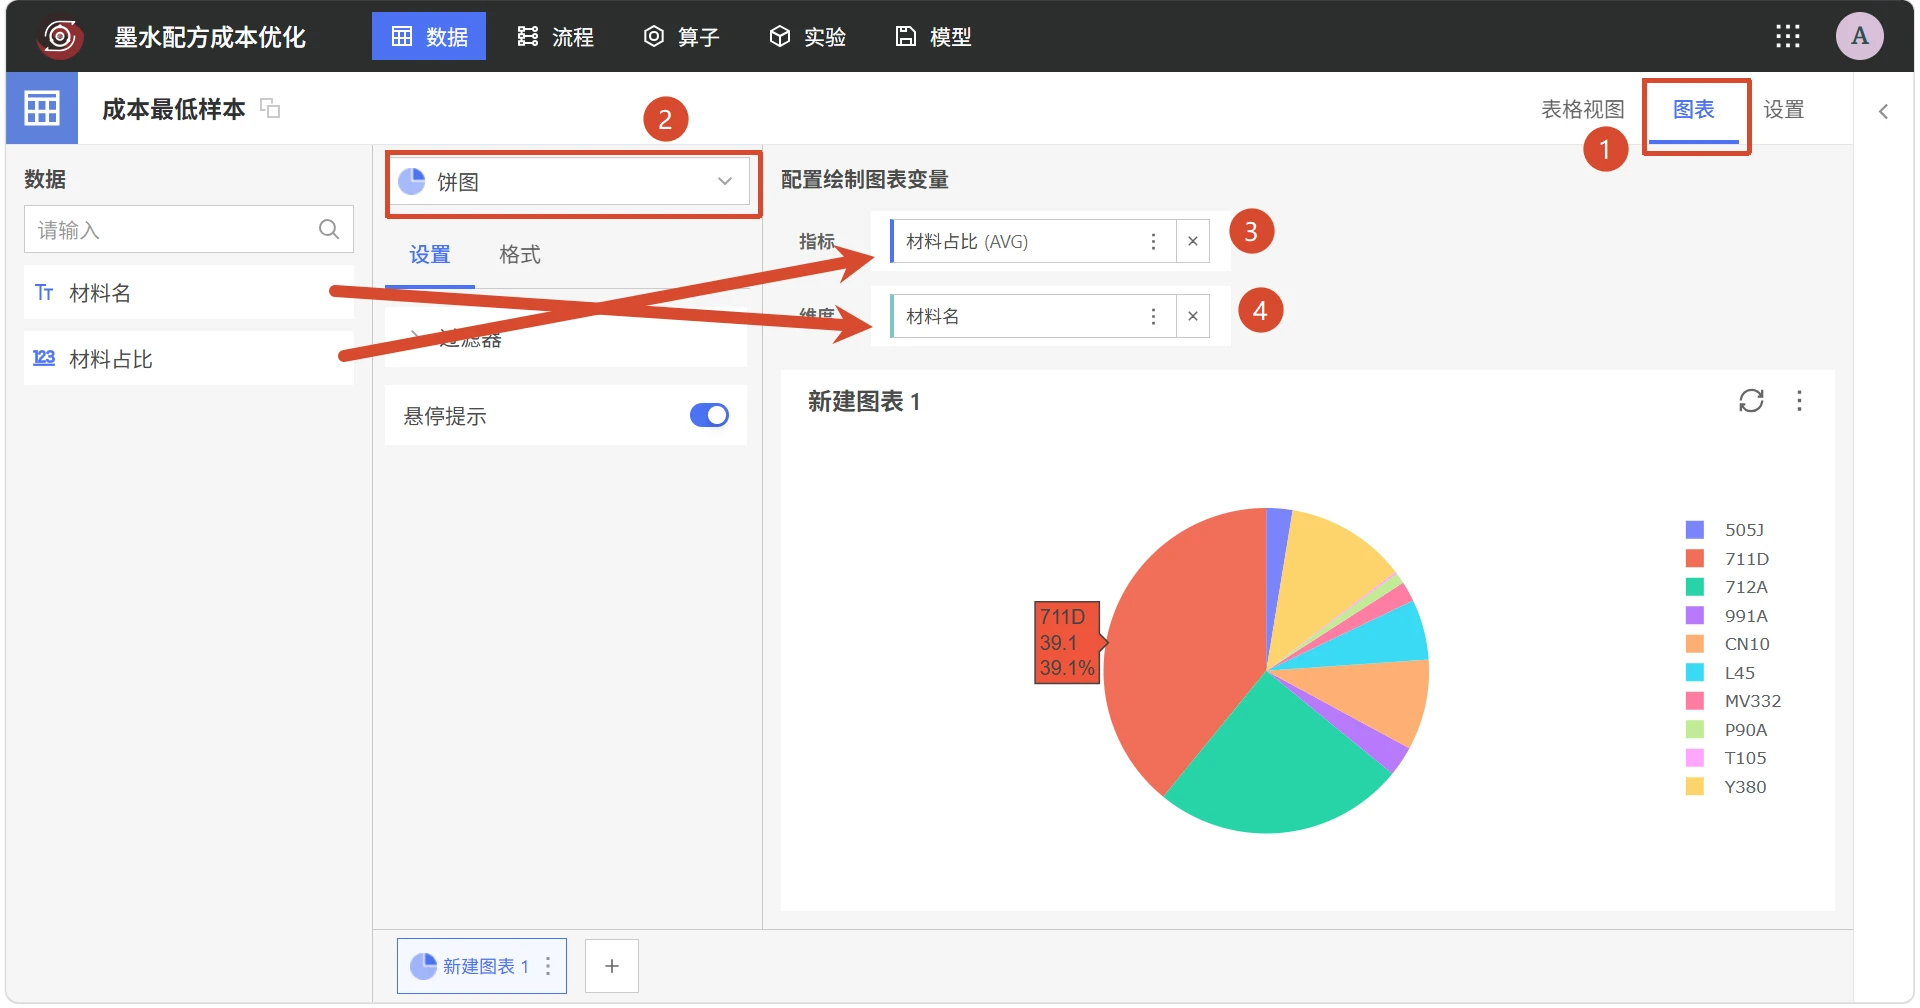 最低成本配方占比
物料属性占比分析
导入物料属性表。
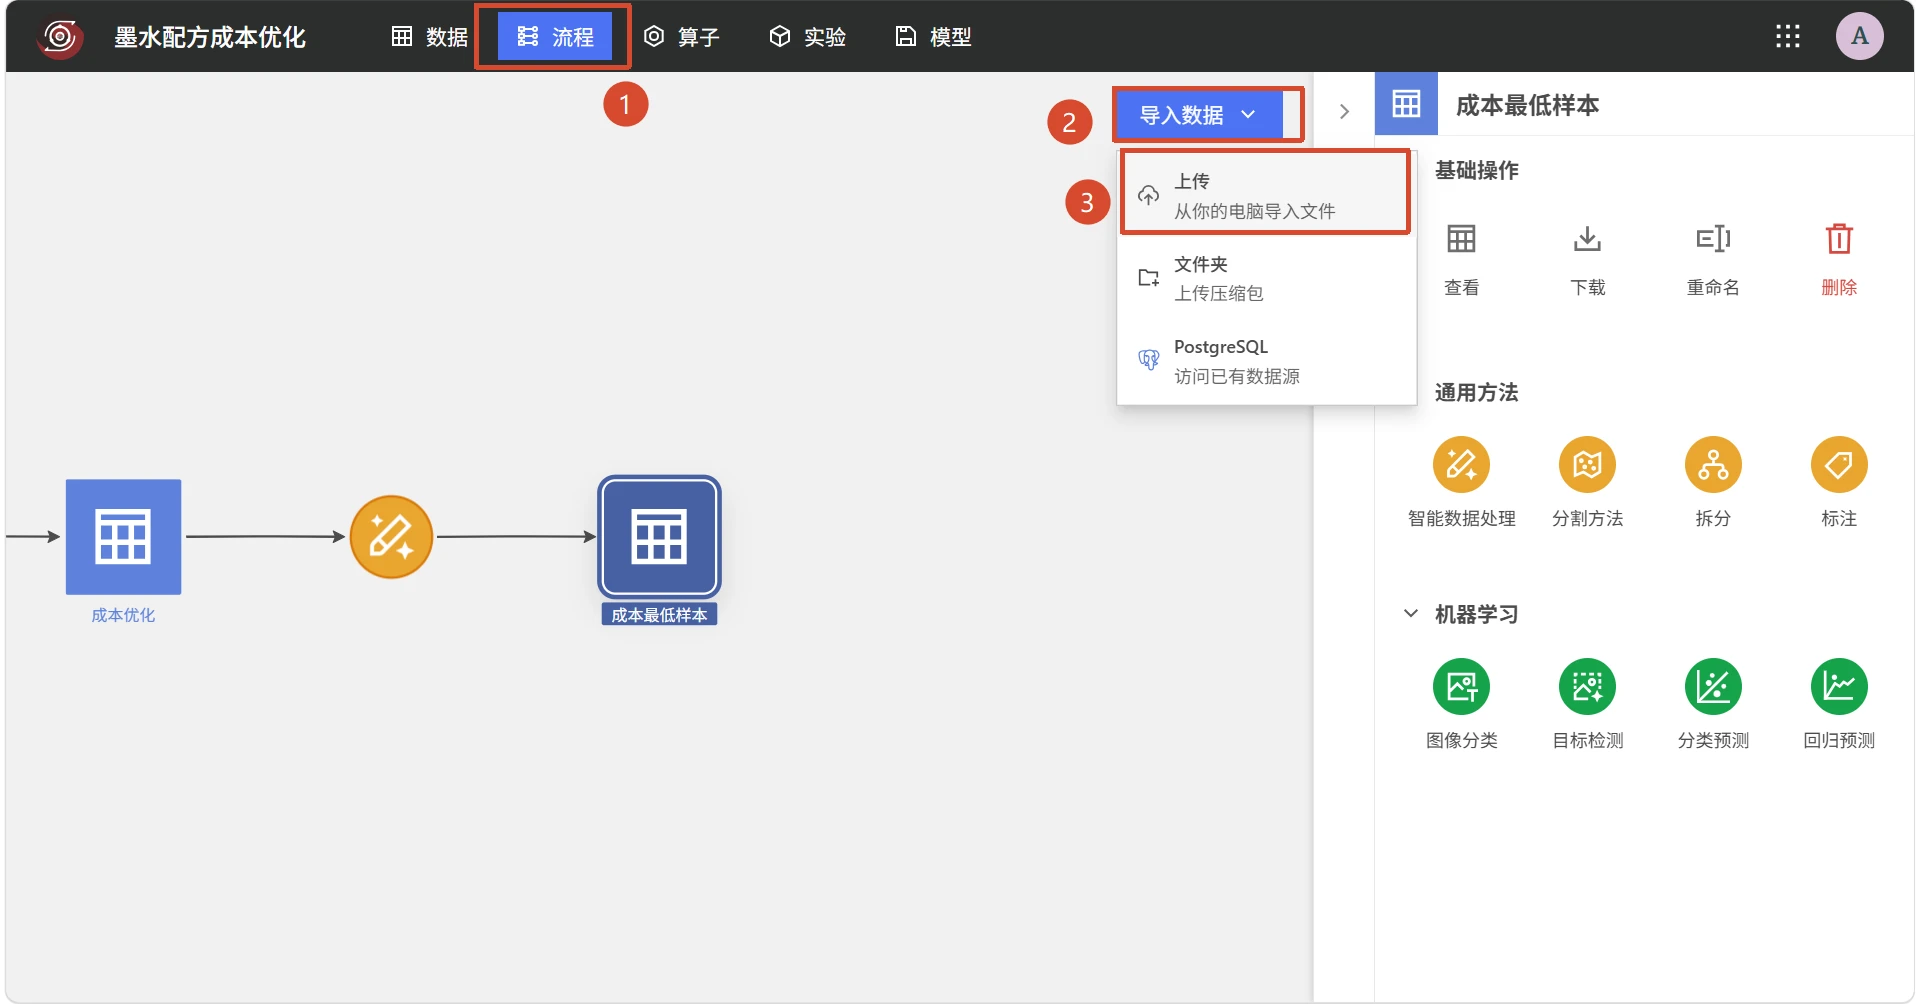 导入物料属性表
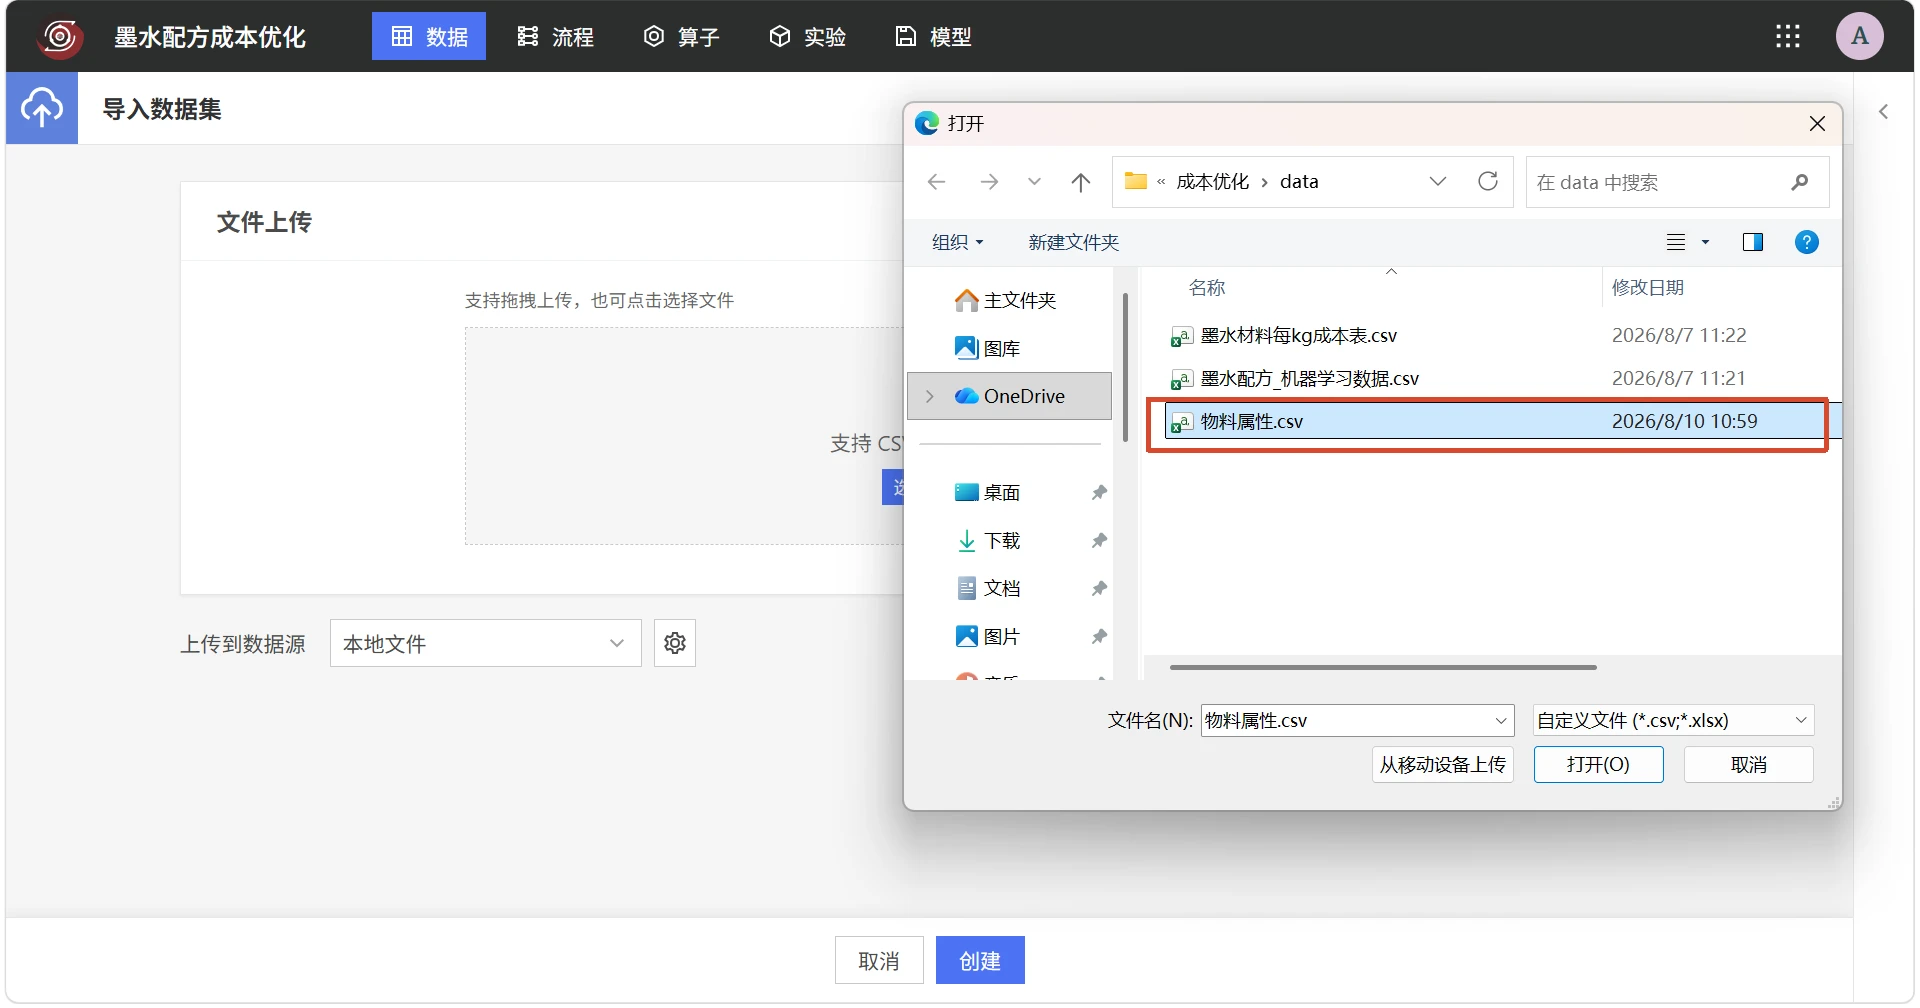 选择物料属性表
物料属性表内记录了物料代码和物料属性的对应关系。
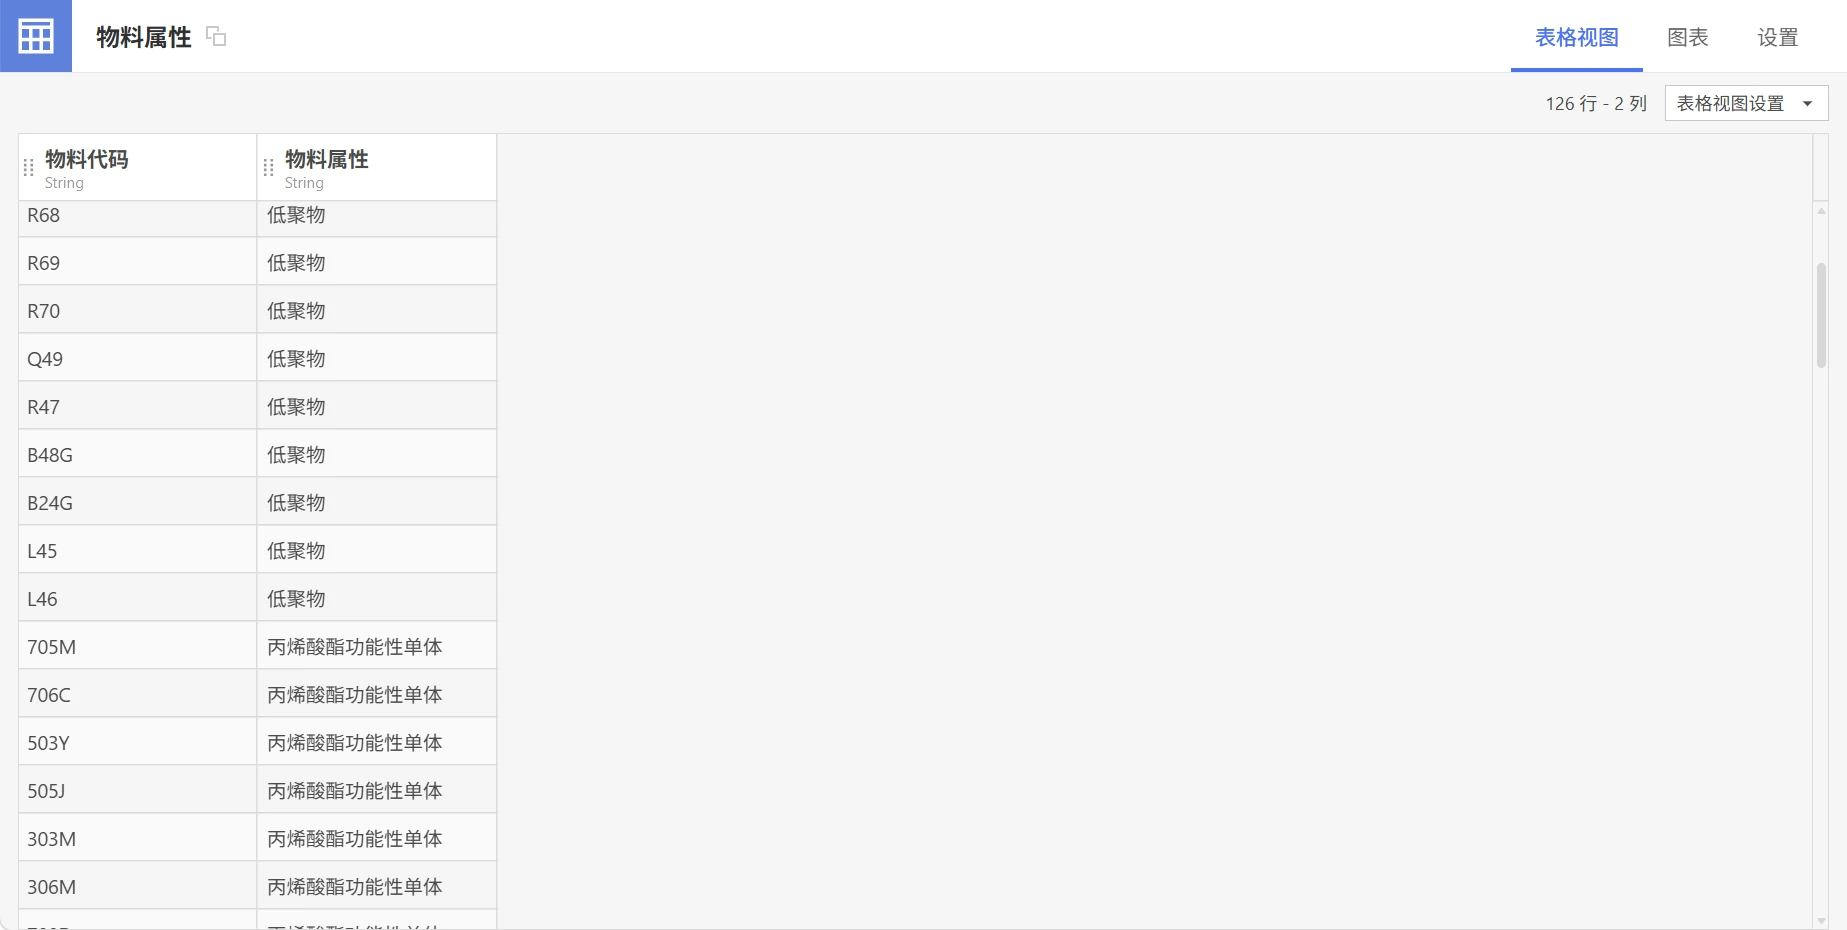 物料属性表预览
回到「流程」画布,选择「成本优化」表,点击右侧【智能数据处理】模块。
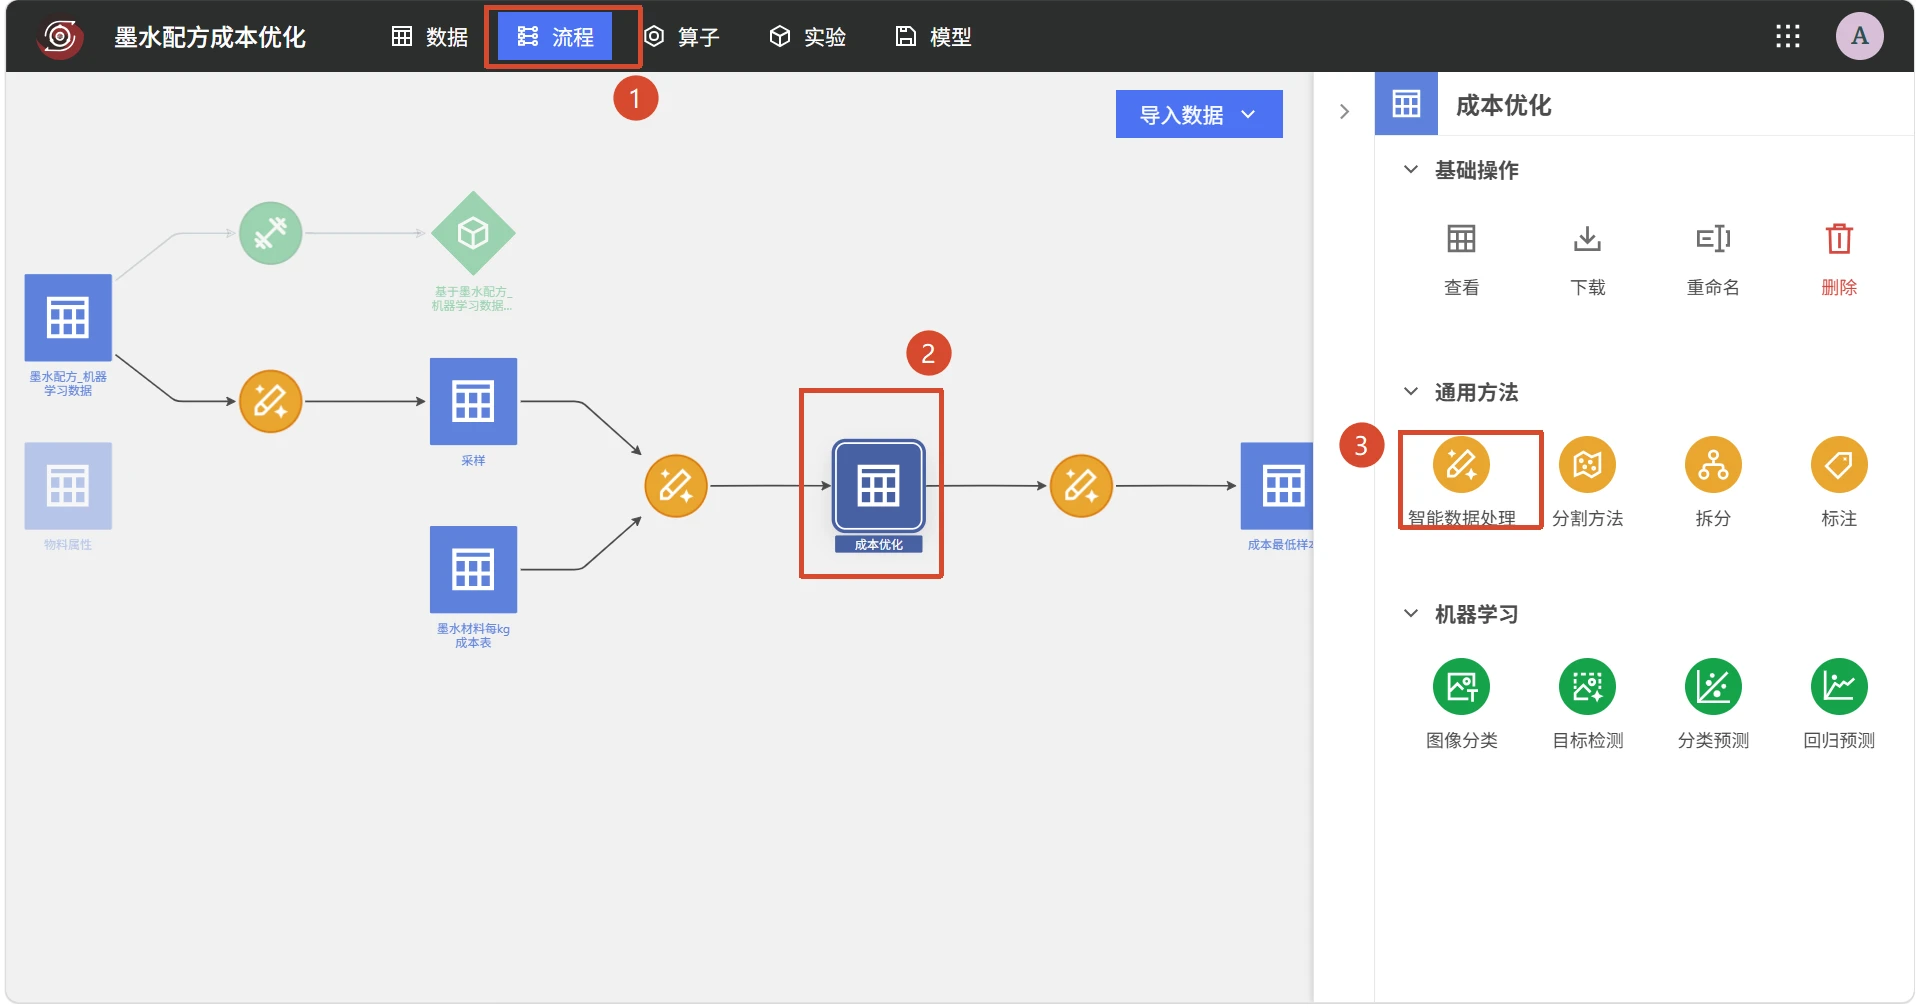 选择成本优化表
输入为「成本优化」和「物料属性」,输出为「物料属性统计」表。
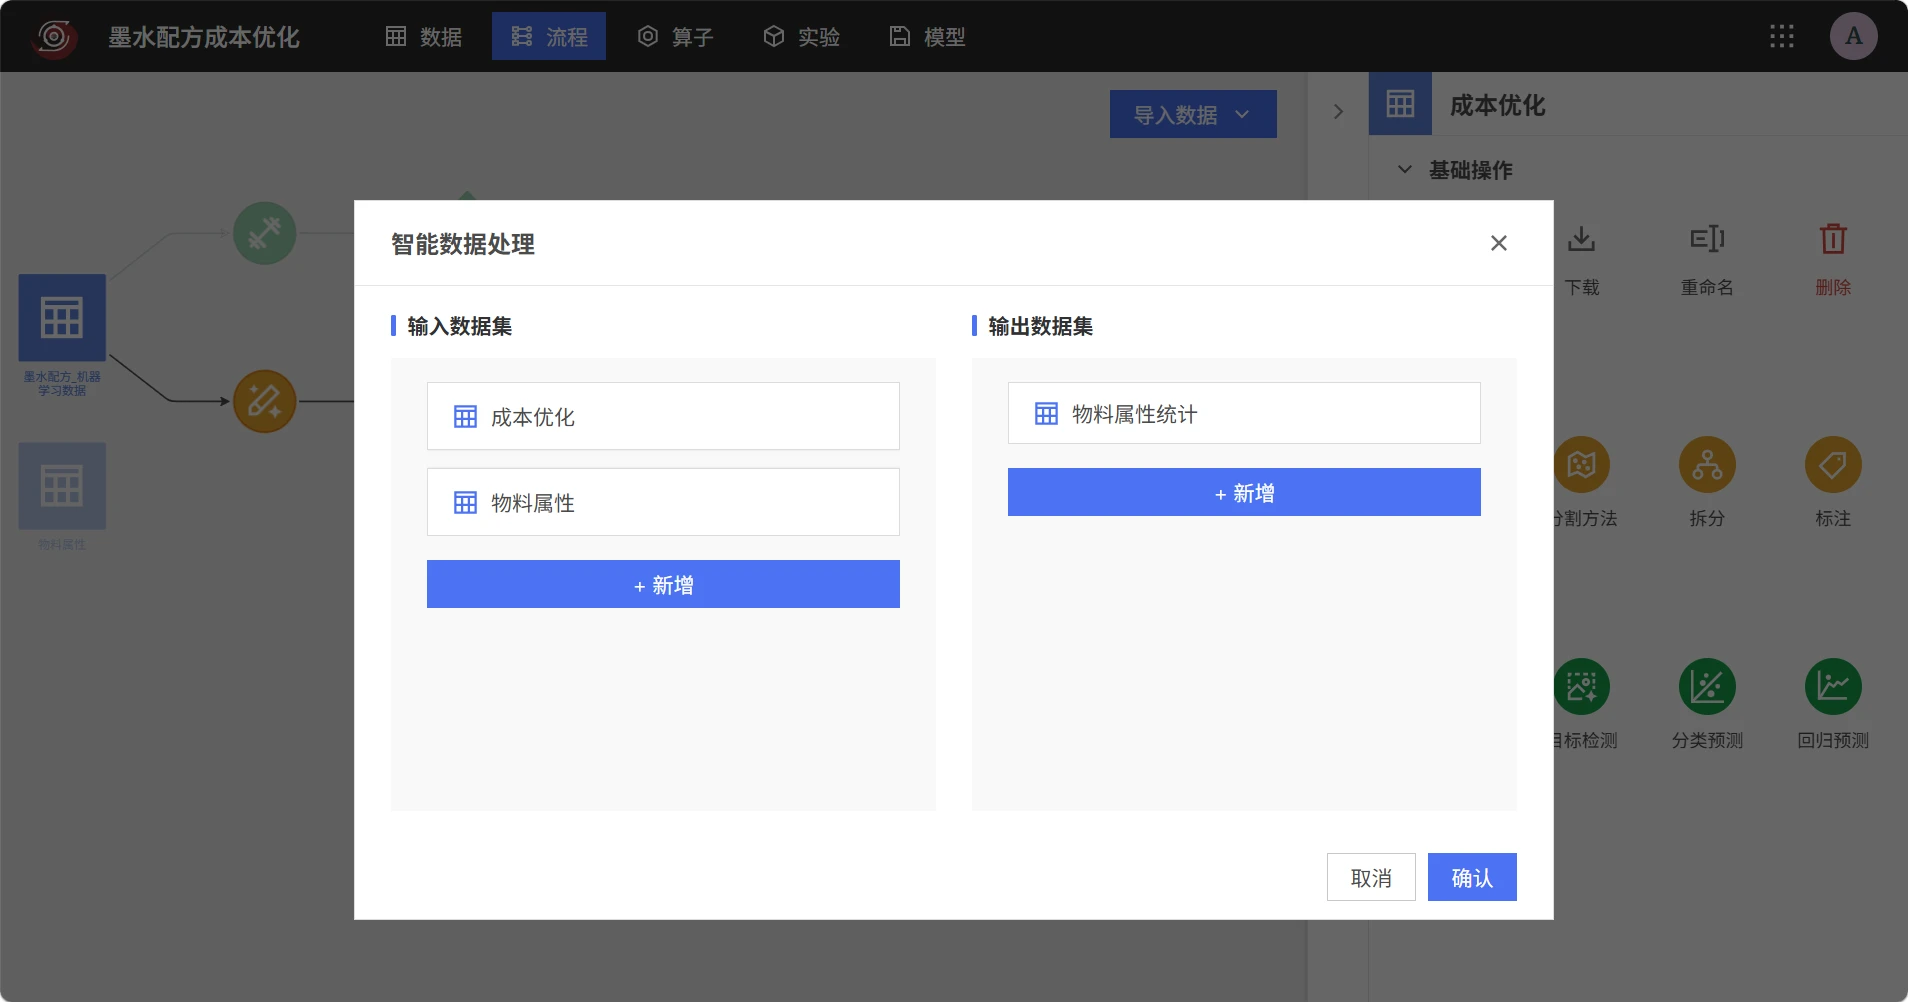 配置物料属性统计
在智能体对话框输入以下提示词:
1. 将“物料属性”中的“物料属性”一列按照“物料代码”映射到“成本优化”数据集里;
2. 对同类型的物料属性进行加和
3. 这个新数据集的列为“低聚物”、“丙烯酸酯功能性单体”、......,行是 40 个样本,里面的值为 R62、R63 等同类属性加和的值。因采样密集,对于成本和配料近乎一致的样本可以进行合并,只保留一个。
4. 请保留成本
5. 增加一个样本1、2、3的命名列
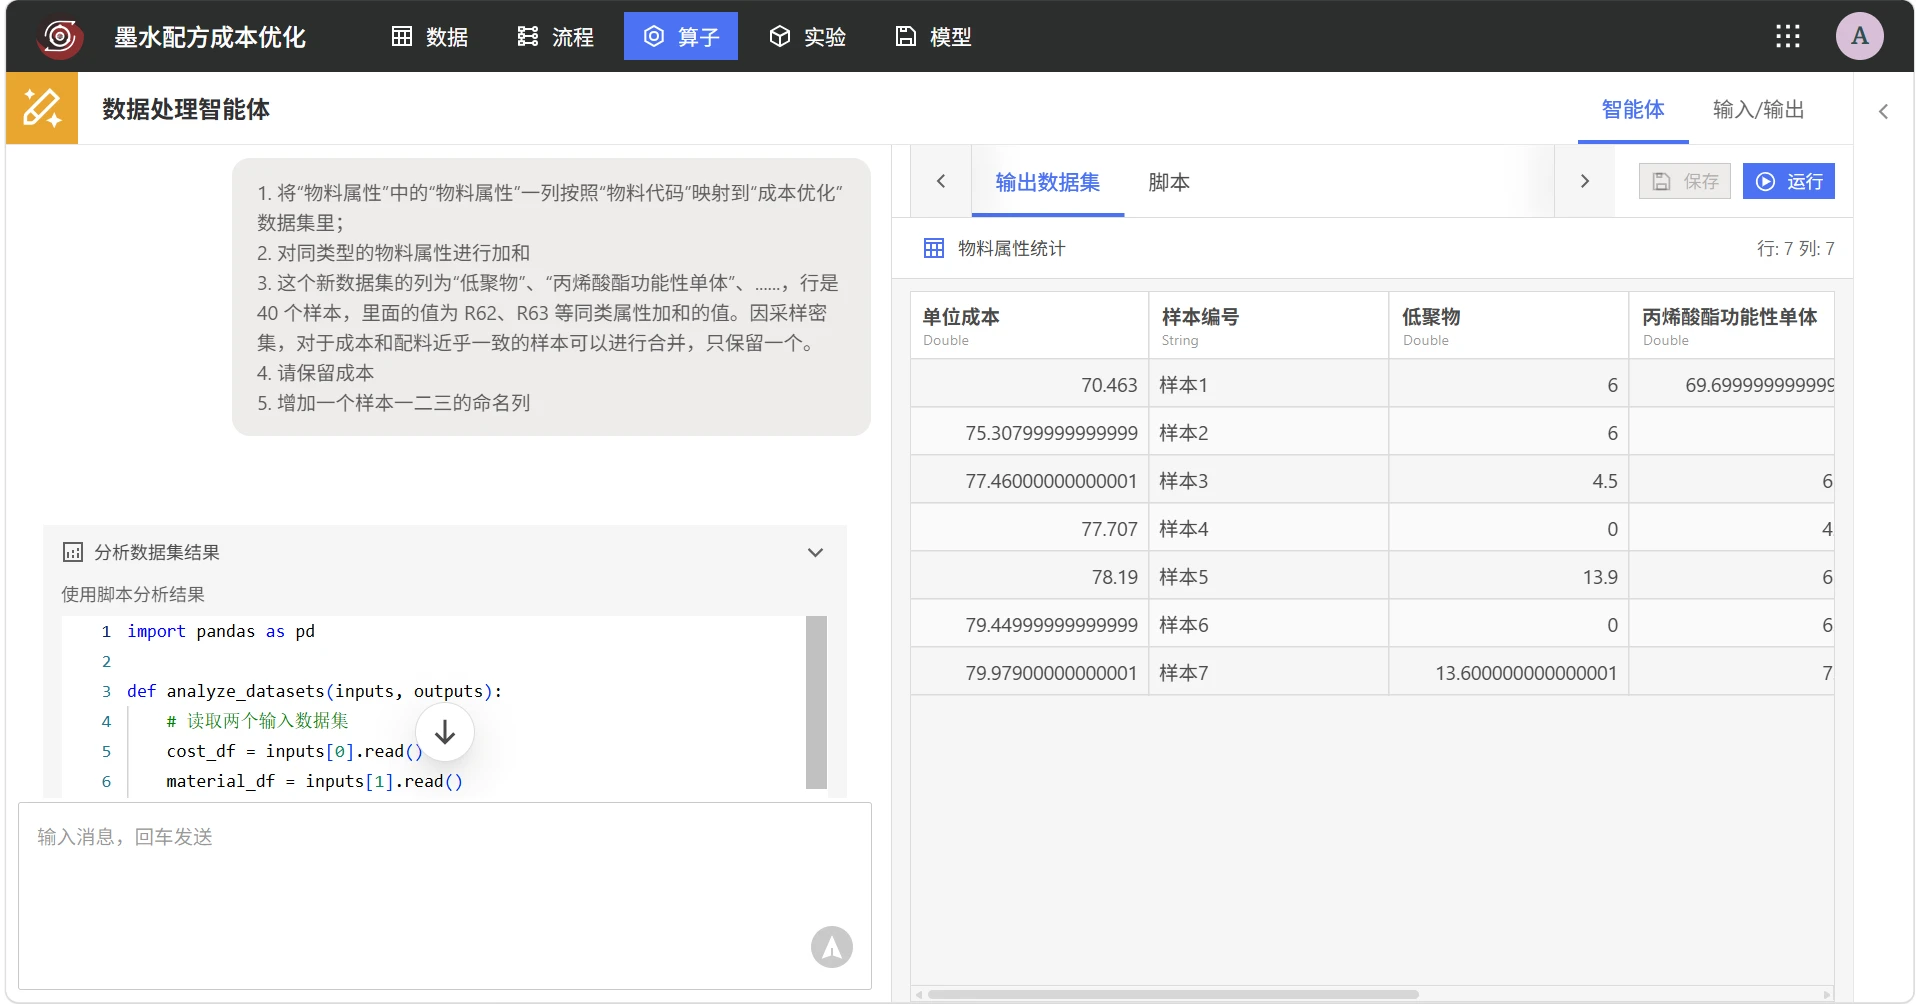 执行物料属性统计
查看生成的「物料属性统计」表。
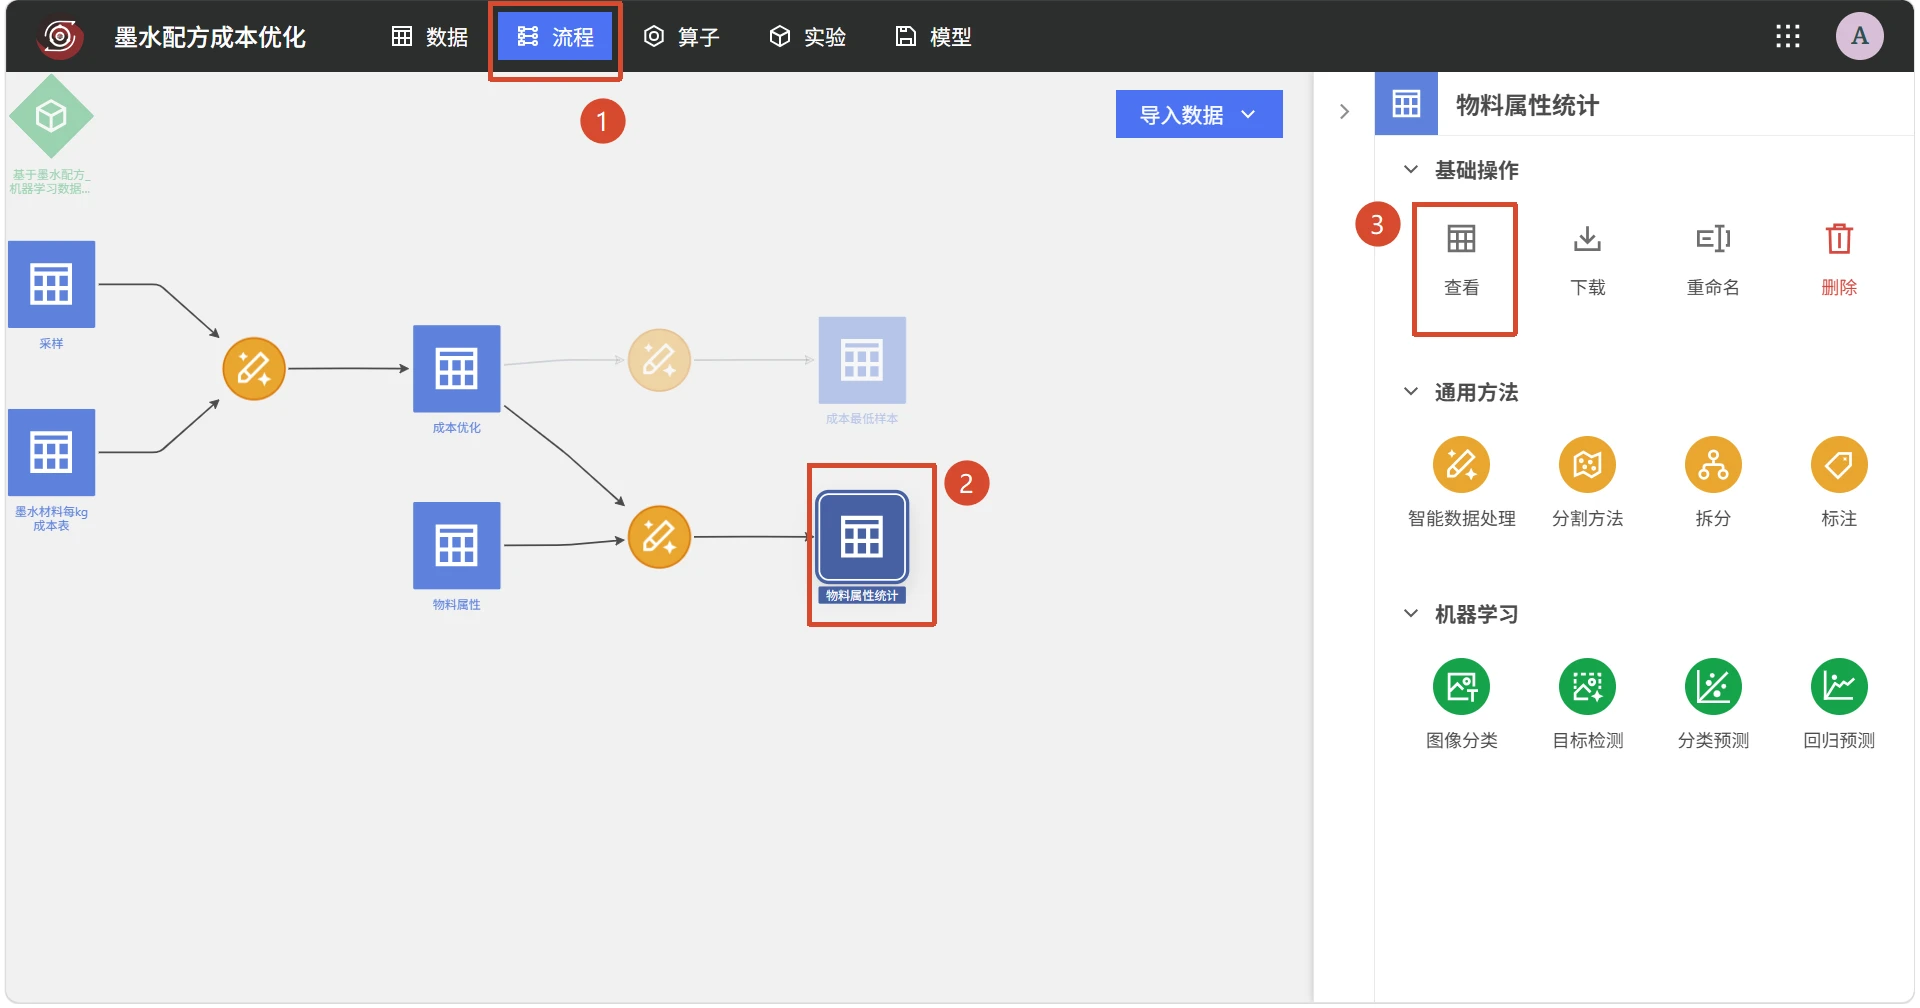 物料属性统计表
在「图表」中,绘制每种属性的物料占比图,可以清晰地查看每个样本不同属性物料的占比。可以看出在这些筛选出的样本中,「丙烯酸酯功能性单体」始终占比最高。
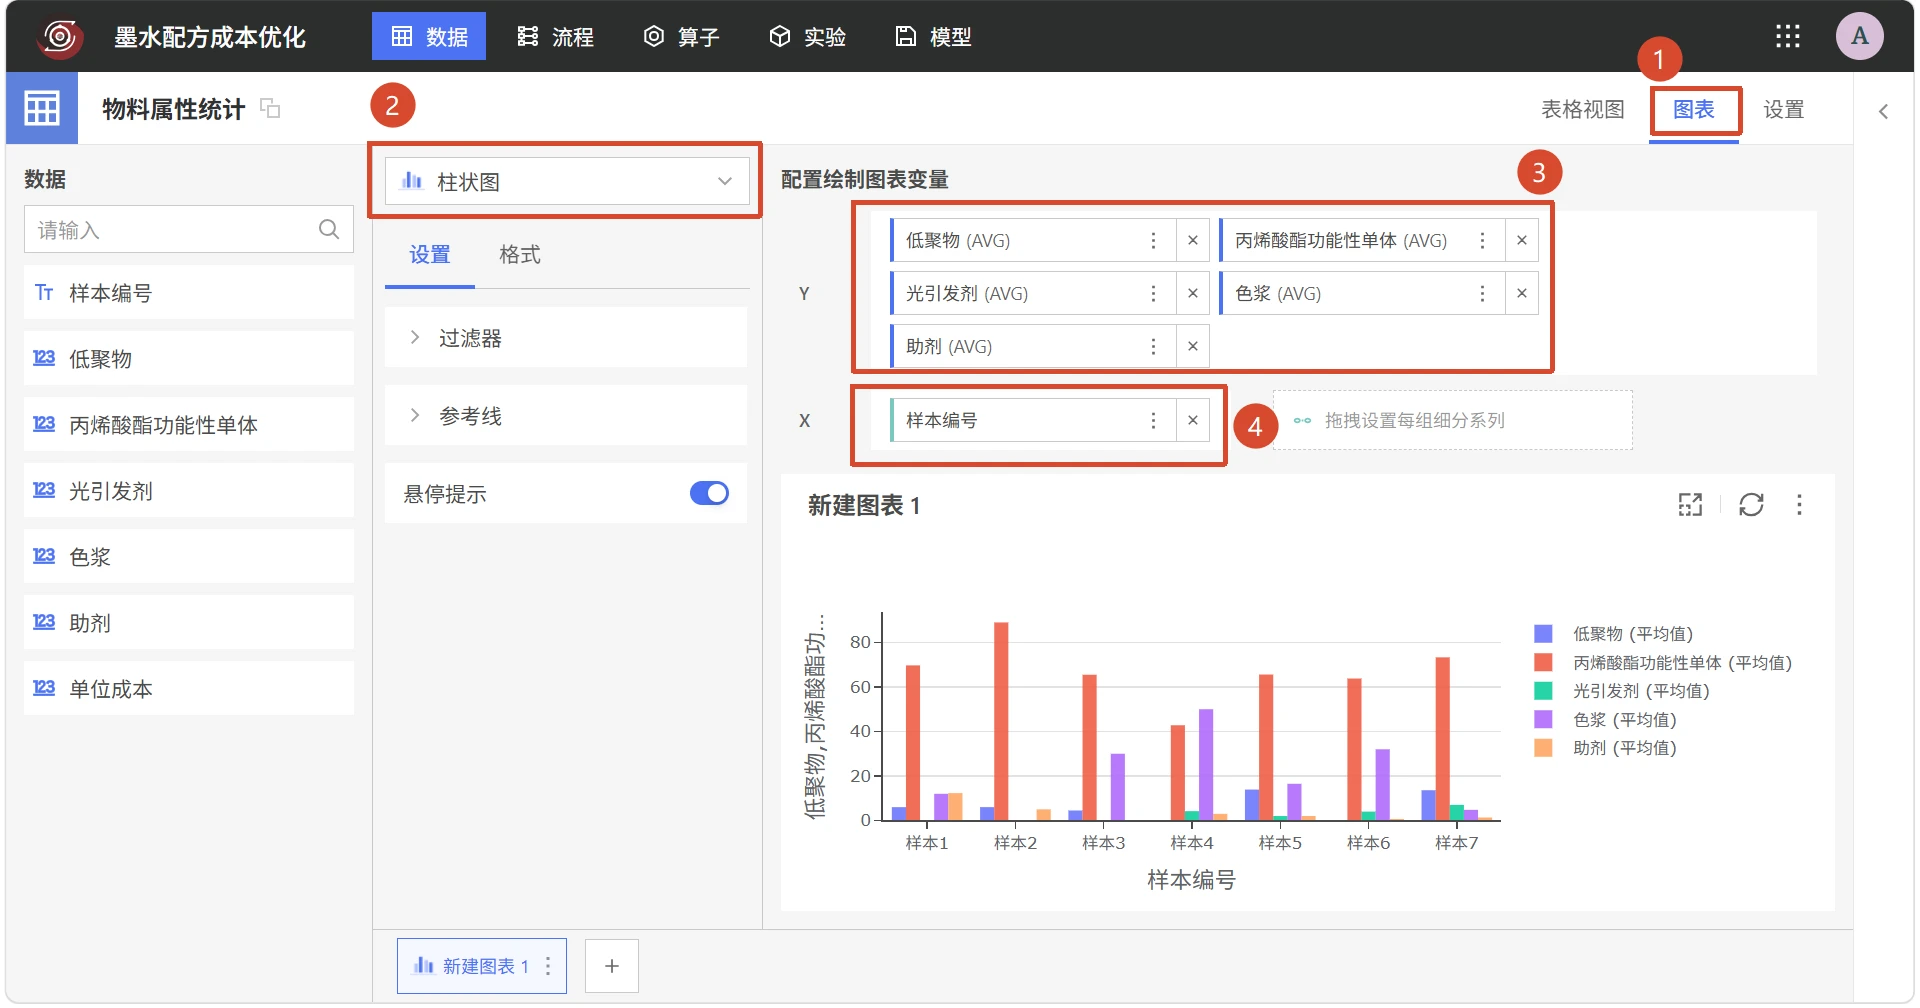 物料属性占比图
案例总结
材料配方成本优化不是单纯降低高价原料用量,而是在性能、成本、工艺和供应等多重约束下寻找更优平衡。与传统回归预测“预测性能值”的方式相比,成本优化能够把“性能合格”和“成本最低”同时纳入决策,直接输出可供研发筛选的候选配方。
本案例以墨水配方为对象,结合历史配方数据和原料单位成本表,在拉伸性能、粘度等指标满足要求的前提下,寻优得到成本更低的配方建议。该方法可为墨水、涂料、胶黏剂等材料研发中的降本设计、原料替代和配方迭代提供数据支持。